Live Apache Spark trainingcursussen, zowel online als op locatie en met instructeur, tonen door middel van hands-on praktijk hoe Spark binnen het Big Data-ecosysteem past en hoe u Spark kunt gebruiken voor data-analyse.
Apache Spark training is beschikbaar als 'online live training' of 'op locatie live training'. Online live training (ook wel 'remote live training' genoemd) wordt uitgevoerd via een interactieve remote desktop. Op locatie live training kan zowel lokaal op de locatie van de klant in Leiden als in de corporate trainingcentra van NobleProg in Leiden worden gegeven.
NobleProg -- Uw lokale trainingsprovider
Leiden
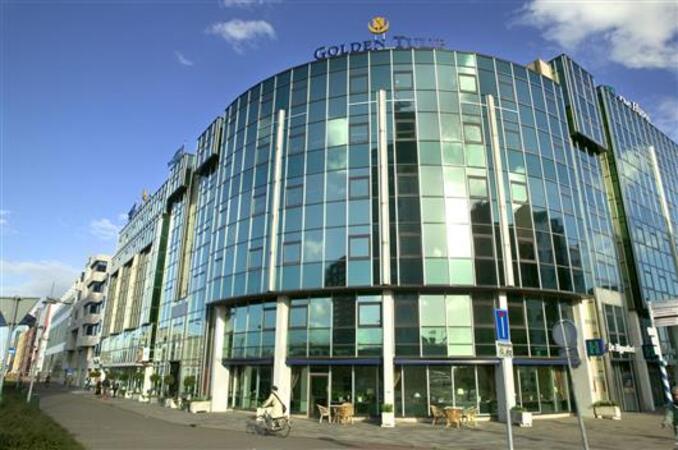
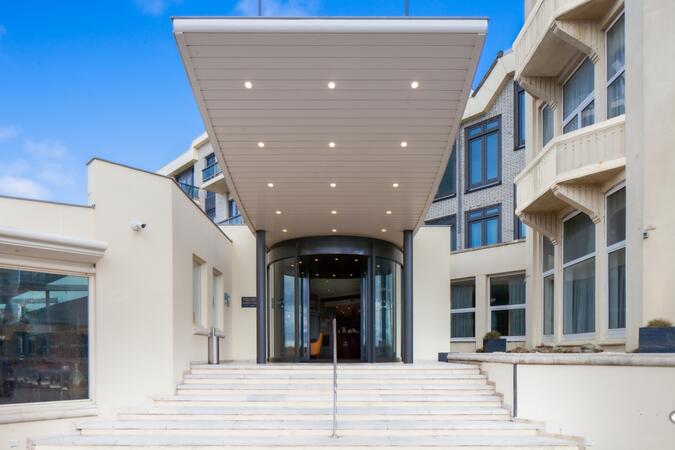
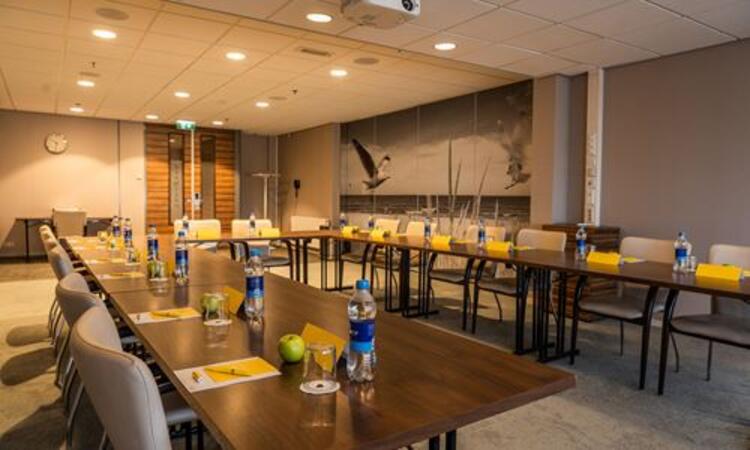
Golden Tulip/Tulip Inn Leiden Centre, Schipholweg 3, Leiden, Nederland, 2316XB
Het 4-sterrenhotel Golden Tulip Leiden Centre ligt direct naast het Tulip Inn Leiden Centre hotel; samen herbergen ze 7 sterren onder 1 dak. De hotels zijn ideaal gelegen met Leiden Centraal Station er direct tegenover en vele snelwegen binnen handbereik. Een prachtige locatie in het centrum van de historische stad Leiden vol musea en schilderachtige plekjes. Beleef, geniet en laat u inspireren.
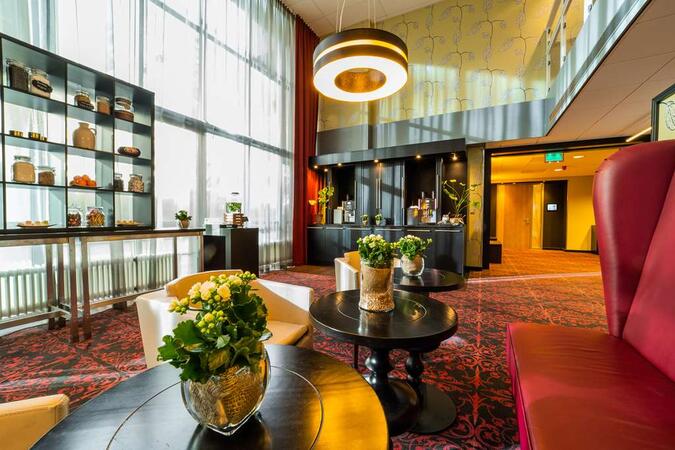
Golden Tulip & Tulip Inn Leiden Centre beschikken over een grote diversiteit aan hotelkamers; van comfortabel en modern ingerichte standaard kamers tot luxe executive kamers. In totaal zijn er 155 kamers. Verder beschikken de hotels over een gerenoveerd restaurant genaamd "Rubens", een gezellige bar/lounge en een uitgebreid meeting & conference center.
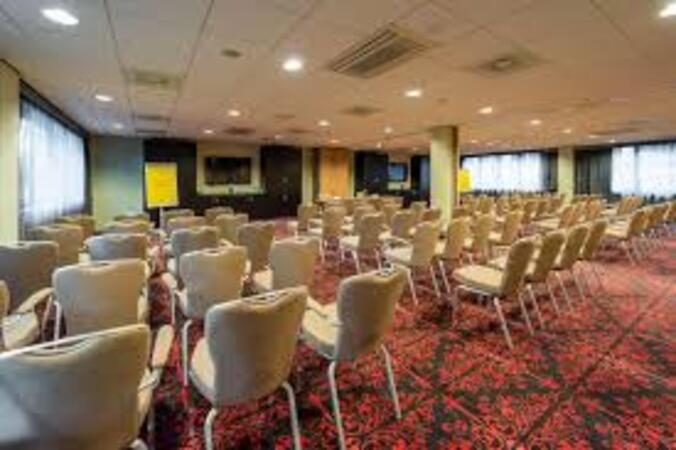
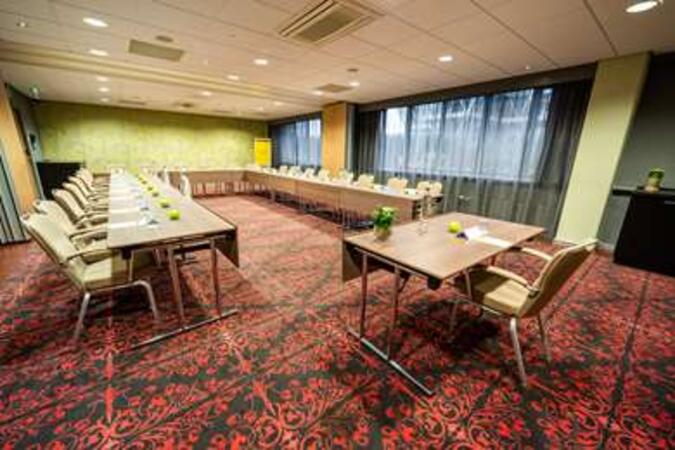
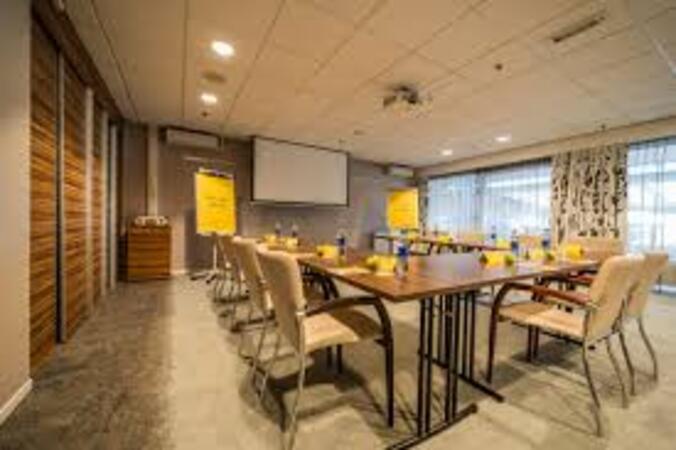
De 6 multifunctionele zalen maken Golden Tulip & Tulip Inn Leiden Centre tot de ideale locatie voor kleine en middelgrote bijeenkomsten. De zalen hebben een capaciteit van 4 tot 100 personen. De vergaderzalen bieden talloze mogelijkheden wat betreft opstelling en technische faciliteiten. Gemak, efficiency, gastvrijheid en professionaliteit staan voorop. Alle zalen hebben airconditioning, gratis draadloos internet en daglicht.
Tot in de vroege 19e eeuw vormde de visserij de belangrijkste inkomstenbron in Noordwijk aan Zee. Na verloop van tijd begon de lokale bevolking zich echter steeds meer op het toerisme te richten. Tegenwoordig vinden er jaarlijks meer dan 1 miljoen overnachtingen plaats in het gebied. Noordwijk aan Zee bestaat uit verschillende wijken en is gelegen op de duinen. Het herbergt diverse horecagelegenheden, waaronder hotels, uitgaanscentra en restaurants, waarvan sommige direct aan het strand liggen. Bovendien is er een winkelcentrum dat op zondag geopend is. Elk jaar worden evenementen gehouden op de boulevard rond de vuurtoren op het Vuurtorenplein. De gemeente heeft een KNRM-reddingstation en een hervormde kerk uit 1647 met een preekstoel uit de 17e eeuw.
Na de fusie met de gemeente Noordwijkerhout is de grotere gemeente nu verdeeld in vier centra. Noordwijk aan Zee, oorspronkelijk een vissersdorp, is uitgegroeid tot een badplaats met een lang kustgebied van ongeveer 13 km. De stad heeft twee boulevards, elk vernoemd naar een koningin, de Koningin Wilhelmina Boulevard en de Koningin Astrid Boulevard.
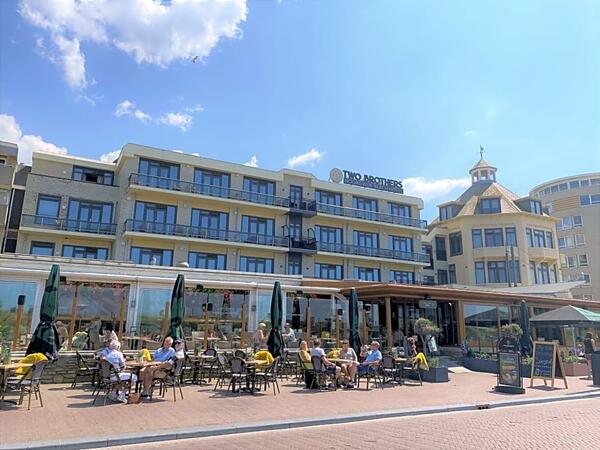
Het Two Brothers Noordwijk Beach Hotel ligt aan de boulevard van Noordwijk met zicht op het dorp en de zee en heeft meerdere conferentiezalen en trainingslokalen die het de perfect plek maken voor zakelijke bijeenkomsten en stimulerende trainingen. Noordwijk is 30 minuten rijden verwijderd van Amsterdam en Den Haag en slechts 20 minuten vanaf Leiden.
Deze praktijkgerichte training onder begeleiding van een docent (online of op locatie) richt zich op datawetenschappers en -engineers met een gemiddelde kennisgraad die Google Colab en Apache Spark willen gebruiken voor big data-verwerking en analyse.
Na afloop van deze training zullen deelnemers in staat zijn om:
Een big data-omgeving op te zetten met behulp van Google Colab en Spark.
Grote datasets efficiënt te verwerken en te analyseren met Apache Spark.
Big data visueel weer te geven in een collaboratieve omgeving.
Apache Spark te integreren met cloudgebaseerde hulpmiddelen.
Deze live training met een docent in Leiden behandelt het Stratio-platform, met een focus op de modulen Rocket en Intelligence met PySpark. Deelnemers maken data-inname, transformatie en geavanceerde analitieken meester, en verwerven praktische vaardigheden in lussen, UDF's en enterprise data-workflows.
Deze begeleide, live-training in Leiden (online of op locatie) richt zich op ontwikkelaars die Spark, Hadoop en Python willen gebruiken om grote en complexe datasets te verwerken, analyseren en transformeren.
Aan het einde van deze training zullen deelnemers in staat zijn tot het volgende:
Het instellen van de benodigde omgeving voor het verwerken van big data met Spark, Hadoop en Python.
De kenmerken, kernonderdelen en architectuur van Spark en Hadoop begrijpen.
Leren hoe Spark, Hadoop en Python te integreren zijn voor big data-verwerking.
De tools binnen het Spark-ecosysteem verkennen (Spark MlLib, Spark Streaming, Kafka, Sqoop, en Flume).
Samenwerkingsgerichte aanbevelingssystemen ontwikkelen, vergelijkbaar met die van Netflix, YouTube, Amazon, Spotify en Google.
Apache Mahout gebruiken om machine learning-algoritmen te schalen.
Deze door een instructeur geleide, live training in Leiden (online of ter plaatse) is bedoeld voor systeembeheerders met een beginnend tot intermediair niveau die Spark-clusters willen implementeren, onderhouden en optimaliseren.
Na afloop van deze training kunnen deelnemers:
Apache Spark installeren en configureren in diverse omgevingen.
Clusterbronnen beheren en Spark-toepassingen monitoren.
De prestaties van Spark-clusters optimaliseren.
Beveiligingsmaatregelen implementeren en hoge beschikbaarheid garanderen.
Fouten opsporen en algemene Spark-problemen oplossen.
In deze door een instructor geleide live training in Leiden, leren deelnemers hoe ze Python en Spark samen gebruiken om Big Data te analyseren, terwijl ze aan de hand van praktische oefeningen werken.
Aan het einde van deze training zijn deelnemers in staat om:
Te leren hoe Spark met Python wordt gebruikt voor het analyseren van Big Data.
Te werken aan oefeningen die echte situaties simuleren.
Onderscheiden tools en technieken te gebruiken voor big data-analyse met behulp van PySpark.
Deze instructeur-gestuurde, live training (online of ter plaatse) is gericht op data engineers, data analisten en data professionals die Databricks en PySpark willen gebruiken om schaalbare datapipelines te bouwen en bestaande SQL-workflows te migreren.
Deze training biedt een praktische introductie tot het ontwikkelen van schaalbare dataprocessings- en Machine Learning-workflows met behulp van PySpark. Deelnemers leren hoe Apache Spark functioneert binnen moderne big data-omgevingen en hoe ze grote datasets efficiënt verwerken aan de hand van principes van gedistribueerde berekeningen.
Dit driedaags praktisch cursusprogramma richt zich op het bouwen en optimaliseren van efficiënte gegevensverwerkingswerkbelastingen met PySpark, Pandas en Polars in Kubernetes-omgevingen.
Deelnemers ontwikkelen een praktisch inzicht in hoe Spark-toepassingen worden uitgevoerd op Kubernetes en hoe beslissingen op applicatieniveau invloed hebben op prestaties, schaalbaarheid, resourcegebruik en kosten. De cursus behandelt belangrijke optimaliseringsgebieden, waaronder executor-grootte, geheugentoewijzing, dynamische toewijzing, partitioneringsstrategieën, shuffle-gedrag, het kleinbestandsprobleem en efficiënte Parquet-verwerking.
De cursus bestrijkt ook veelvoorkomende uitdagingen bij het werken met Pandas, zoals geheugenbeperkingen en out-of-memory-fouten, en introduceert Polars als hoogpresterend alternatief voor geselecteerde gegevensverwerkingswerkbelastingen. Door middel van praktijkoefeningen diagnosticeren deelnemers prestatie- en geheugenproblemen, vergelijken ze verschillende configuratiestrategieën en passen ze optimalisatietechnieken toe op realistische ETL- en machine learning-scenario's.
De nadruk ligt doorheen de cursus op praktische besluitvorming: begrijpen hoe bottlenecks worden geïdentificeerd, het juiste hulpmiddel wordt geselecteerd, Spark efficiënt wordt geconfigureerd en een balans wordt gevonden tussen prestaties en het resourcegebruik en de kosten van de infrastructuur.
Deze door instructeurs geleide live-training in Leiden (online of op locatie) richt zich op engineers die Apache Spark willen implementeren voor het verwerken van zeer grote hoeveelheden data.
Aan het einde van deze training zullen de deelnemers in staat zijn om:
Apache Spark te installeren en configureren.
Zeer grote datasets snel te verwerken en te analyseren.
Het verschil tussen Apache Spark en Hadoop MapReduce te begrijpen, evenals wanneer je het een of het ander gebruikt.
Apache Spark te integreren met andere machine learning-tools.
Deze interactieve training in Leiden maakt Apache Spark toegankelijk en behandelt onderwerpen zoals RDD's, DataFrames en Python/Scala-API's. Deelnemers masteren cloud-deployment met Databricks, AWS EMR en Glue, en verwerven praktische vaardigheden voor effectieve data engineering- en DevOps-taken in de praktijk.
Lees meer...
Laatst bijgewerkt:
Reviews (5)
We tonen verschillende manieren aan om onze PySpark-query's te optimaliseren.
Ivan Abrashev - UBB + DZI (KBC GROUP)
Cursus - Efficient Data Processing on Kubernetes with PySpark, Pandas & Polars
Automatisch vertaald
Een reis door de wereld van Spark: een zeer intensieve cursus. DSL, Spark SQL, partitie versus bucketing voor mij.
Georgiana Elisabeta
Cursus - Apache Spark Fundamentals
Automatisch vertaald
Ik vond het fijn dat het praktisch was. Ik hield ervan om de theoretische kennis toe te passen met praktijkvoorbeelden.
Aurelia-Adriana - Allianz Services Romania
Cursus - Python and Spark for Big Data (PySpark)
Automatisch vertaald
Het feit dat we de meeste informatie, cursussen, presentaties en oefeningen mee konden nemen, zodat we ze kunnen doornemen en eventueel herhalen wat we het eerste keer niet begrepen of verbeteren wat we al gedaan hebben.
Raul Mihail Rat - Accenture Industrial SS
Cursus - Python, Spark, and Hadoop for Big Data
Automatisch vertaald
Praktijklessen/opdrachten hebben
Poornima Chenthamarakshan - Intelligent Medical Objects
Apache Spark training cursus in Leiden, Apache Spark opleiding cursus in Leiden, Weekend Apache Spark cursus in Leiden, Avond Apache Spark training in Leiden, Spark instructeur geleid Leiden, Spark privé cursus in Leiden, Apache Spark on-site in Leiden, Weekend Spark training in Leiden, Avond Apache Spark cursus in Leiden, Apache Spark een op een training in Leiden, Spark instructeur in Leiden, Apache Spark coaching in Leiden, Spark boot camp in Leiden, Apache Spark trainer in Leiden, Spark instructeur geleid in Leiden,Apache Spark lessen in Leiden, Apache Spark op locatie in Leiden, Spark een op een opleiding in Leiden