Live Apache Spark trainingcursussen, zowel online als op locatie en met instructeur, tonen door middel van hands-on praktijk hoe Spark binnen het Big Data-ecosysteem past en hoe u Spark kunt gebruiken voor data-analyse.
Apache Spark training is beschikbaar als 'online live training' of 'op locatie live training'. Online live training (ook wel 'remote live training' genoemd) wordt uitgevoerd via een interactieve remote desktop. Op locatie live training kan zowel lokaal op de locatie van de klant in Amsterdam als in de corporate trainingcentra van NobleProg in Amsterdam worden gegeven.
NobleProg -- Uw lokale trainingsprovider
Amsterdam
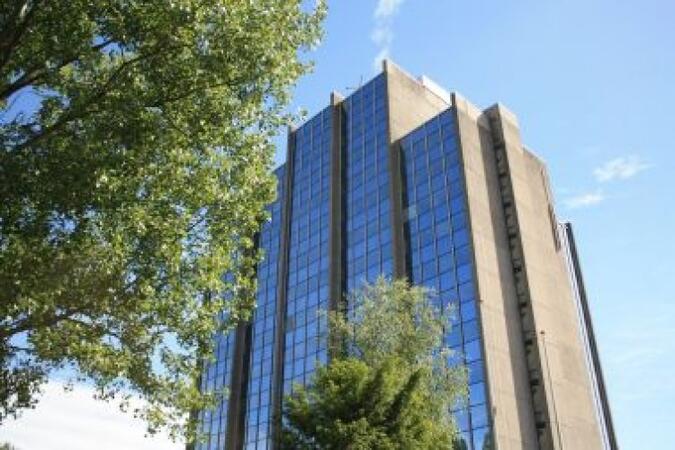
The Office Operators, Piet Heinkade 55, Amsterdam, Nederland, 1019 GM
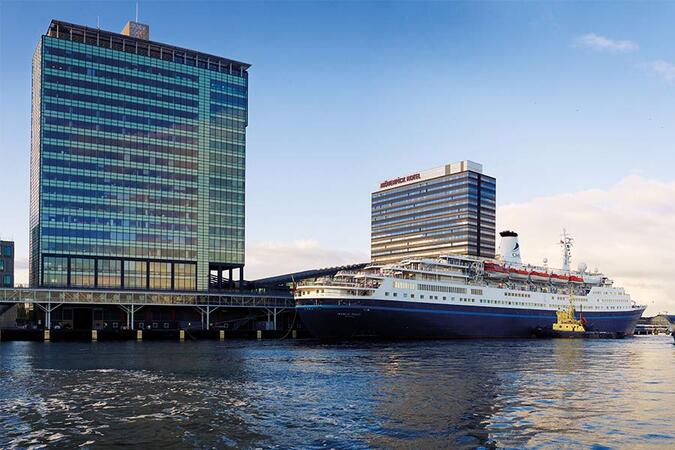
UP Office Building is gelegen in het centrum van Amsterdam aan de zuidelijke IJ-oever nabij het centraal station. Het UP Office Building maakt onderdeel uit van een multifunctioneel complex waarin onder meer de Passenger Terminal Amsterdam (PTA), het Mövenpick Hotel en het Muziekgebouw zijn ondergebracht. Onder het complex is een openbare parkeergarage met ruim voldoende voor de verhuur beschikbare plaatsen. Vanuit de garage is een directe ingang naar het kantoorgebouw. Met 21 bouwlagen is het UP Office Building het hoogste gebouw in de omgeving en fungeert daarmee als een 'landmark'.
Trainingen bijwonen in Amsterdam Centrum aan de IJ-oever is vergaderen op een super centrale en goed bereikbare locatie. Ons gebouw ligt namelijk op loopafstand – maar gelukkig niet op gehoorafstand -van Amsterdam CS
Openbaar Vervoer
UP Office Building ligt op 12 minuten lopen vanaf Amsterdam Centraal Station. Of neem tram 26, deze stopt voor het gebouw en brengt u in enkele maten naar het station.
Met de auto
Met de auto is het slechts 1 km via A10 afslag S114. Parkeren kan in the Piet Hein garage.
WTC Zuidas
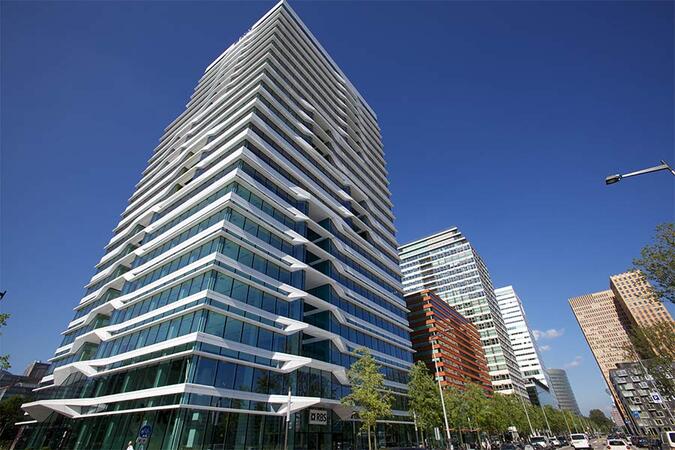
The Office Operators - Amsterdam Zuidas - UN Studio, Parnassusweg 819, Amsterdam, Nederland, 1082 LZ
Ons trainingslocatie in Amsterdam Zuidas WTC heeft 10 verschillende ruimtes en zalen beschikbaar.
Vergaderlocatie Amsterdam ZuidAs WTC is uitstekend bereikbaar met het openbaar vervoer en ligt op loopafstand van trein-, bus- en metrostation ‘Amsterdam Zuid’. Ook met de auto is het WTC Amsterdam perfect bereikbaar. Het meeting- & conference center ligt op een steenworp afstand van de ringweg A10 en de parkeergarage van het WTC Amsterdam biedt ruim voldoende parkeerplaatsen voor u en uw gasten.
De nabij gelegen Station Amsterdam WTC biedt ook direct connecties naar België, Frankrijk en Duitsland.
Sloterdijk
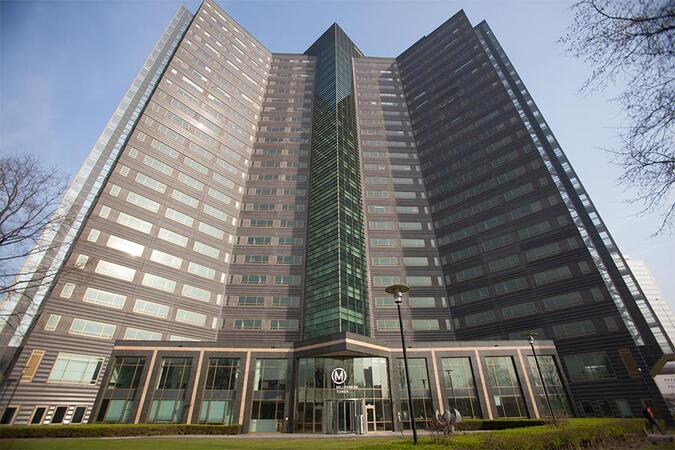
The Office Operators - Amsterdam Sloterdijk - De Millennium Toren, Radarweg 29, 1043 NX Amsterdam, Amsterdam, Nederland, 1043 NX
De Millennium Toren is een absoluut icoon middenin het business district van Amsterdam Sloterdijk. Het op Mondriaans’ Victory Boogiewoogie geïnspireerde gebouw torent boven vele andere uit en is dan ook één van de hoogste gebouwen van Amsterdam. Hierdoor heeft u vanuit uw kantoor een schitterend weids uitzicht over de stad!
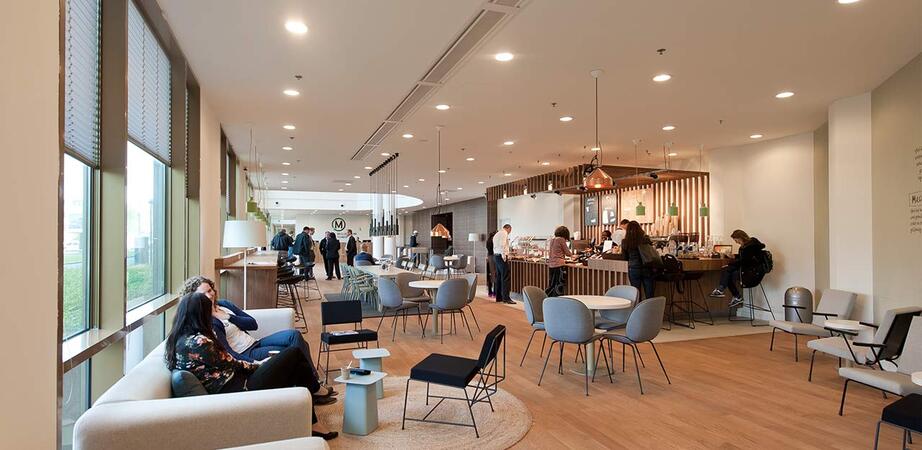
Op de begane grond van de Millennium Toren bevindt zich een groot restaurant waar u heerlijk kunt lunchen, een flex area waar u kunt werken in een informele sfeer én heeft u de mogelijkheid om gebruik te maken van de inpandige gym!
De bereikbaarheid van de Millennium Toren is uitstekend, op slechts 500 meter afstand ligt station Amsterdam Sloterdijk en het pand is direct gelegen aan de A5 en de A10. Wanneer u graag buiten de deur eet zijn er meerdere lunchmogelijkheden rondom de Millennium Toren zoals Grand Café Hermes en restaurant en lunchroom Wissekerke.
Amstelveen
Amstelveen NEST, Laan van Kronenburg 14, Amstelveen, Nederland, 1183 AS
In het begin van de 20e eeuw was Amstelveen een eenvoudig landelijk dorp waar de tijd stilstond. Het dorp was enigermate afgelegen, omdat het geen enkele belangrijke spoorweg- of waterverbinding had. De belangrijkste bron van inkomsten was de veeteelt met wat akkerbouw, maar ook de tuinbouw en de bloementeelt waren toen al in opkomst.
In 1852 werd de Haarlemmermeerpolder drooggemalen en is het 'Fort aan het Schiphol' aangelegd als verdedigingswerk voor de hoofdstad Amsterdam. Bij Fort Schiphol, zoals het later werd genoemd, werd in 1916 een militair vliegveld gesticht, Schiphol, dat vier jaar later een burgerluchthaven werd. Fort Schiphol werd in 1934 gesloopt, de ligging is nog zichtbaar in de wijde kom van de Ringvaart onder het viaduct van de A-9. De ontwikkeling van Schiphol trok veel mensen, waarvan velen zich vestigden in Amstelveen. Ook het hoofdkantoor van de KLM werd hier gevestigd. Amstelveen werd de snelst groeiende gemeente van Nederland.
Na de Tweede Wereldoorlog ving Amstelveen een deel van de Amsterdamse woningnood op en werd tevens officieel één van de woongemeenten van Schiphol. Behalve woningen werden de laatste decennia ook veel kantoren; met name voor het handels-, bank- en verzekeringswezen gebouwd. Het telt grote computercentra en hoofdkantoren voor nationale en internationale instellingen. Hier wonen velen die werkzaam zijn op de luchthaven Schiphol. Nest Amstelveen bruist! Maar liefst 260 verschillende bedrijven en ondernemers hebben hier hun intrek genomen.
Nest creëert plekken die mensen en bedrijven helpen om succesvol te kunnen ondernemen en te ontwikkelen. NobleProg maakt dankbaar gebruik van deze dynamische omgeving.
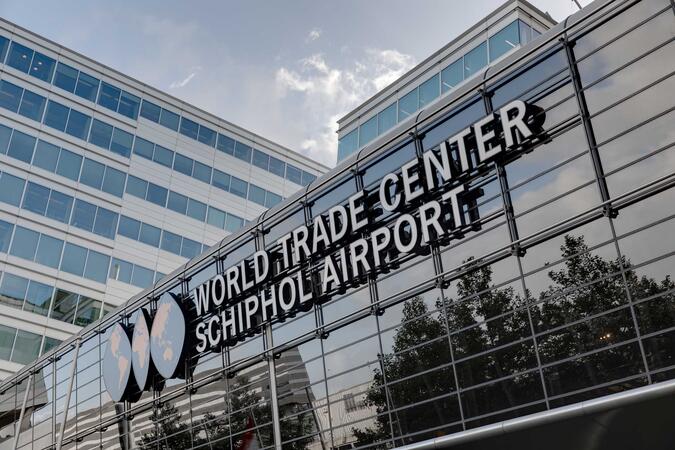
Trainingen op op slechts 5 minuten afstand van de aankomst- en vertrekhal! WTC Schiphol is de meest internationale trainingsplek voor zowel binnenlands al;s buitenlandse deelnemers.
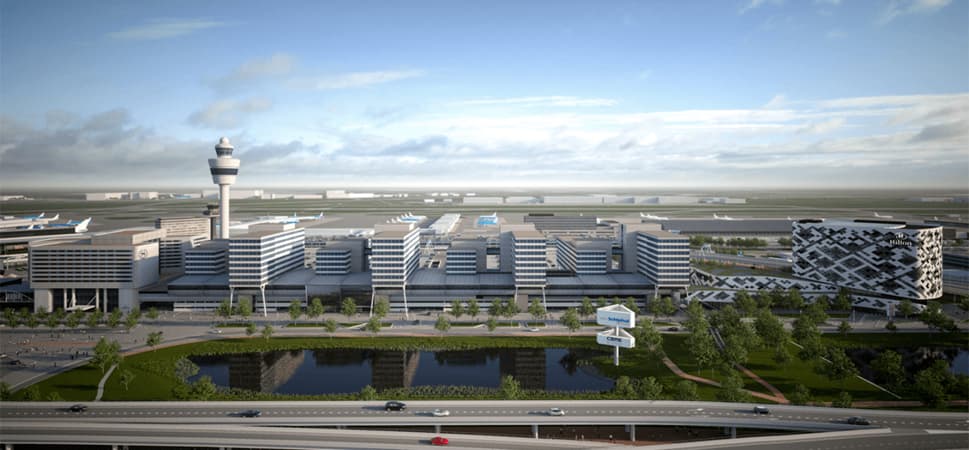
WTC Schiphol Airport is de vestigingslocatie voor grote merken, internationaal georienteerde bedrijven en gedreven ondernemers en biedt directe toegang tot de luchthaven.
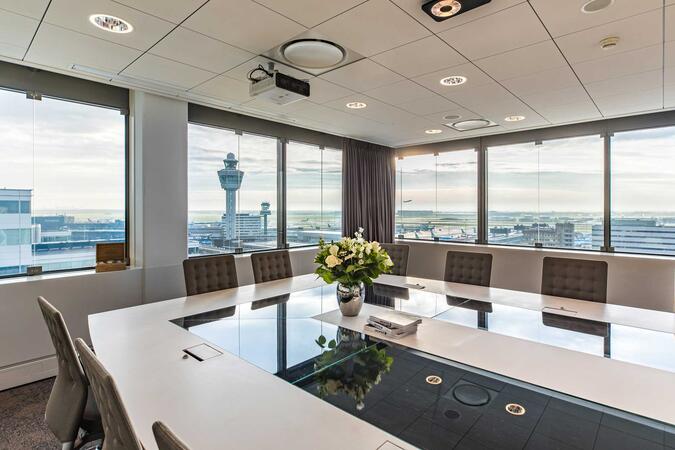
Binnen enkele minuten loopt u van uw trainingslocatie naar de Terminal van luchthaven Schiphol, de tweede hub-luchthaven van de wereld.
Schiphol airport is makkelijk bereikbaar zowel met de auto als me het openbaar vervoer en kent volop gelegenheid tot parkeren.
.
Deze praktijkgerichte training onder begeleiding van een docent (online of op locatie) richt zich op datawetenschappers en -engineers met een gemiddelde kennisgraad die Google Colab en Apache Spark willen gebruiken voor big data-verwerking en analyse.
Na afloop van deze training zullen deelnemers in staat zijn om:
Een big data-omgeving op te zetten met behulp van Google Colab en Spark.
Grote datasets efficiënt te verwerken en te analyseren met Apache Spark.
Big data visueel weer te geven in een collaboratieve omgeving.
Apache Spark te integreren met cloudgebaseerde hulpmiddelen.
Deze live training onder begeleiding van een docent in Amsterdam behandelt het Stratio-platform, met de focus op de Rocket- en Intelligence-modules met PySpark. Deelnemers beheersen data-ingest, transformatie en geavanceerde analytieken en verwerven praktische vaardigheden in lussen, UDF's en enterprise-data-workflows.
Deze begeleide, live-training in Amsterdam (online of op locatie) richt zich op ontwikkelaars die Spark, Hadoop en Python willen gebruiken om grote en complexe datasets te verwerken, analyseren en transformeren.
Aan het einde van deze training zullen deelnemers in staat zijn tot het volgende:
Het instellen van de benodigde omgeving voor het verwerken van big data met Spark, Hadoop en Python.
De kenmerken, kernonderdelen en architectuur van Spark en Hadoop begrijpen.
Leren hoe Spark, Hadoop en Python te integreren zijn voor big data-verwerking.
De tools binnen het Spark-ecosysteem verkennen (Spark MlLib, Spark Streaming, Kafka, Sqoop, en Flume).
Samenwerkingsgerichte aanbevelingssystemen ontwikkelen, vergelijkbaar met die van Netflix, YouTube, Amazon, Spotify en Google.
Apache Mahout gebruiken om machine learning-algoritmen te schalen.
Deze door een instructeur geleide, live training in Amsterdam (online of ter plaatse) is bedoeld voor systeembeheerders met een beginnend tot intermediair niveau die Spark-clusters willen implementeren, onderhouden en optimaliseren.
Na afloop van deze training kunnen deelnemers:
Apache Spark installeren en configureren in diverse omgevingen.
Clusterbronnen beheren en Spark-toepassingen monitoren.
De prestaties van Spark-clusters optimaliseren.
Beveiligingsmaatregelen implementeren en hoge beschikbaarheid garanderen.
Fouten opsporen en algemene Spark-problemen oplossen.
In deze door een instructor geleide live training in Amsterdam, leren deelnemers hoe ze Python en Spark samen gebruiken om Big Data te analyseren, terwijl ze aan de hand van praktische oefeningen werken.
Aan het einde van deze training zijn deelnemers in staat om:
Te leren hoe Spark met Python wordt gebruikt voor het analyseren van Big Data.
Te werken aan oefeningen die echte situaties simuleren.
Onderscheiden tools en technieken te gebruiken voor big data-analyse met behulp van PySpark.
Deze instructeur-gestuurde, live training (online of ter plaatse) is gericht op data engineers, data analisten en data professionals die Databricks en PySpark willen gebruiken om schaalbare datapipelines te bouwen en bestaande SQL-workflows te migreren.
Deze training biedt een praktische introductie tot het ontwikkelen van schaalbare dataprocessings- en Machine Learning-workflows met behulp van PySpark. Deelnemers leren hoe Apache Spark functioneert binnen moderne big data-omgevingen en hoe ze grote datasets efficiënt verwerken aan de hand van principes van gedistribueerde berekeningen.
Deze driedaagse praktische cursus richt zich op het bouwen en optimaliseren van efficiënte dataverwerkingsworkloads met PySpark, Pandas en Polars in Kubernetes-gebaseerde omgevingen.
Deelnemers krijgen een praktisch inzicht in hoe Spark-toepassingen op Kubernetes worden uitgevoerd en hoe beslissingen over configuratie op toepassingsniveau de prestaties, schaalbaarheid, bronverbruik en kosten beïnvloeden. De cursus dekt belangrijke optimalisatiegebieden, waaronder executorgrootte, geheugentoewijzing, dynamische toewijzing, partitioneringsstrategieën, shuffle-gedrag, het probleem van kleine bestanden en efficiënte Parquet-verwerking.
De cursus behandelt ook veelvoorkomende uitdagingen bij het werken met Pandas, zoals geheugenbeperkingen en out-of-memory-fouten, en introduceert Polars als een hoogwaardig alternatief voor geselecteerde dataverwerkingsworkloads. Tijdens praktische oefeningen diagnosticeren deelnemers prestatie- en geheugenproblemen, vergelijken ze verschillende configuratiestrategieën en passen ze optimalisatietechnieken toe op realistische ETL- en machinelearning-scenario's.
De nadruk ligt tijdens de hele cursus op praktisch beslissen: begrijpen hoe knelpunten te identificeren zijn, het juiste tool te selecteren, Spark efficiënt te configureren en de balans te vinden tussen prestaties, infrastructuurbronverbruik en kosten.
Deze door instructeurs geleide live-training in Amsterdam (online of op locatie) richt zich op engineers die Apache Spark willen implementeren voor het verwerken van zeer grote hoeveelheden data.
Aan het einde van deze training zullen de deelnemers in staat zijn om:
Apache Spark te installeren en configureren.
Zeer grote datasets snel te verwerken en te analyseren.
Het verschil tussen Apache Spark en Hadoop MapReduce te begrijpen, evenals wanneer je het een of het ander gebruikt.
Apache Spark te integreren met andere machine learning-tools.
Deze interactieve training in Amsterdam maakt Apache Spark toegankelijk en behandelt onderwerpen zoals RDD's, DataFrames en Python/Scala-API's. Deelnemers masteren cloud-deployment met Databricks, AWS EMR en Glue, en verwerven praktische vaardigheden voor effectieve data engineering- en DevOps-taken in de praktijk.
Lees meer...
Laatst bijgewerkt:
Reviews (4)
Een reis door de wereld van Spark: een zeer intensieve cursus. DSL, Spark SQL, partitie versus bucketing voor mij.
Georgiana Elisabeta
Cursus - Apache Spark Fundamentals
Automatisch vertaald
Ik vond het fijn dat het praktisch was. Ik hield ervan om de theoretische kennis toe te passen met praktijkvoorbeelden.
Aurelia-Adriana - Allianz Services Romania
Cursus - Python and Spark for Big Data (PySpark)
Automatisch vertaald
Het feit dat we de meeste informatie, cursussen, presentaties en oefeningen mee konden nemen, zodat we ze kunnen doornemen en eventueel herhalen wat we het eerste keer niet begrepen of verbeteren wat we al gedaan hebben.
Raul Mihail Rat - Accenture Industrial SS
Cursus - Python, Spark, and Hadoop for Big Data
Automatisch vertaald
Praktijklessen/opdrachten hebben
Poornima Chenthamarakshan - Intelligent Medical Objects
Spark training cursus in Amsterdam, Spark opleiding cursus in Amsterdam, Weekend Spark cursus in Amsterdam, Avond Apache Spark training in Amsterdam, Apache Spark instructeur geleid Amsterdam, Avond Spark cursus in Amsterdam, Apache Spark on-site in Amsterdam, Apache Spark instructeur geleid in Amsterdam,Apache Spark lessen in Amsterdam, Apache Spark privé cursus in Amsterdam, Apache Spark op locatie in Amsterdam, Spark instructeur in Amsterdam, Weekend Apache Spark training in Amsterdam, Apache Spark een op een training in Amsterdam, Spark boot camp in Amsterdam, Apache Spark een op een opleiding in Amsterdam, Spark coaching in Amsterdam, Apache Spark trainer in Amsterdam